Base de connaissances avec un assistant IA qui fonctionne sur votre propre serveur avec un LLM local.
Les personnes de votre entreprise posent leurs questions en langage courant et obtiennent des réponses tirées de vos propres documents, avec les sources affichées. Le modèle d'IA fonctionne sur votre serveur : vous ne dépendez d'aucun fournisseur d'IA. Aucun fournisseur ne peut augmenter vos tarifs, et aucune question ni réponse ne quitte votre réseau.
$ git clone https://github.com/deformator852/archfold && cd archfold$ cd backend && uv run install && cd ..$ deploy/deploy.sh build && deploy/deploy.sh up$ deploy/deploy.sh admin you@company.com

- Des réponses vérifiablesChaque réponse cite ses sources et le signale quand aucun document n'a la réponse.
- Un accès selon vos règlesChacun n'obtient de réponses que des documents qu'il a le droit de lire, et chaque lecture est journalisée.
- Un serveur ordinaireDocker Compose sur une machine Linux, à partir de 16 Go de RAM et sans GPU.
- Open sourceApache 2.0, avec tout le code sur GitHub et sans serveur de licences.
Posez une question, obtenez une réponse que vous pouvez vérifier.
Archfold est un assistant privé pour les documents de votre entreprise. Vous importez contrats, politiques et manuels, et chacun l'interroge dans un chat, comme il le ferait avec un collègue.
Chaque réponse indique d'où elle vient
Chaque réponse liste les documents utilisés. Ouvrez-en un pour voir le passage exact, avec les mots correspondants surlignés.
Quand aucun document ne répond à la question, Archfold le dit au lieu d'inventer. Chaque réponse est signalée comme rédigée par une IA.


- Recherche
- Hybride : recherche vectorielle par le sens et correspondance exacte de mots-clés, pour trouver noms, codes et nombres mot pour mot
- Modèle
- Fonctionne dans Ollama sur votre serveur,
llama3.1:8bpar défaut - Réponses
- Diffusées par WebSockets, marquées
ai_generateddans l'API
Il lit les fichiers que vous avez déjà
PDF, Word, OpenDocument, Excel, CSV, JSON, XML, Markdown et texte brut. Importez jusqu'à 50 fichiers à la fois, de 32 Mo chacun, et suivez le traitement en direct.
Les tableaux, les titres et les lignes de feuilles de calcul gardent leur structure : une réponse peut donc citer une cellule ou une clause.
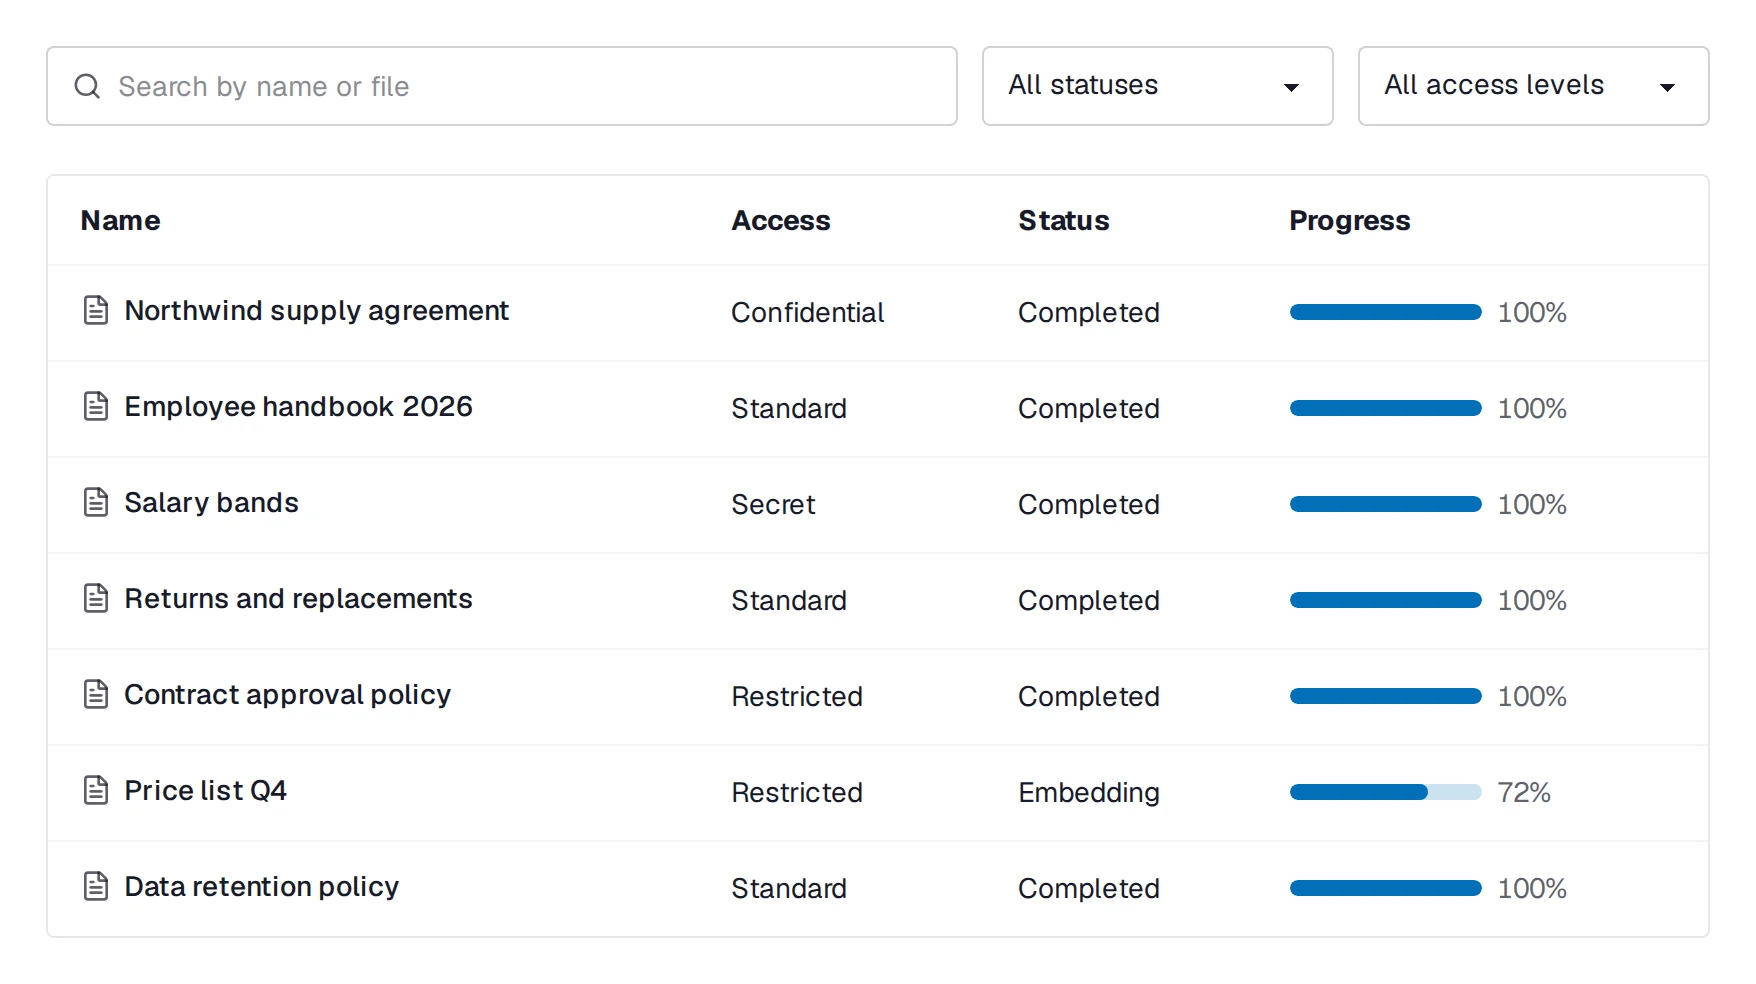
- Traitement
- Un worker Celery avec RabbitMQ extrait le texte, le découpe aux limites de section, calcule les embeddings et l'indexe
- Index
- Qdrant, avec un modèle d'embeddings ouvert de Hugging Face
- Fragments
CHUNK_SIZE=800,CHUNK_OVERLAP=150, modifiables sans perdre de documents
L'administration courante se fait dans le navigateur
Les administrateurs ajoutent des personnes, attribuent des rôles, consultent l'historique des chats et les évaluations des réponses, et vérifient que chaque élément fonctionne, le tout depuis l'interface web.
Des réglages comme le modèle d'IA ou les langues se changent avec une seule commande : uv run configure.
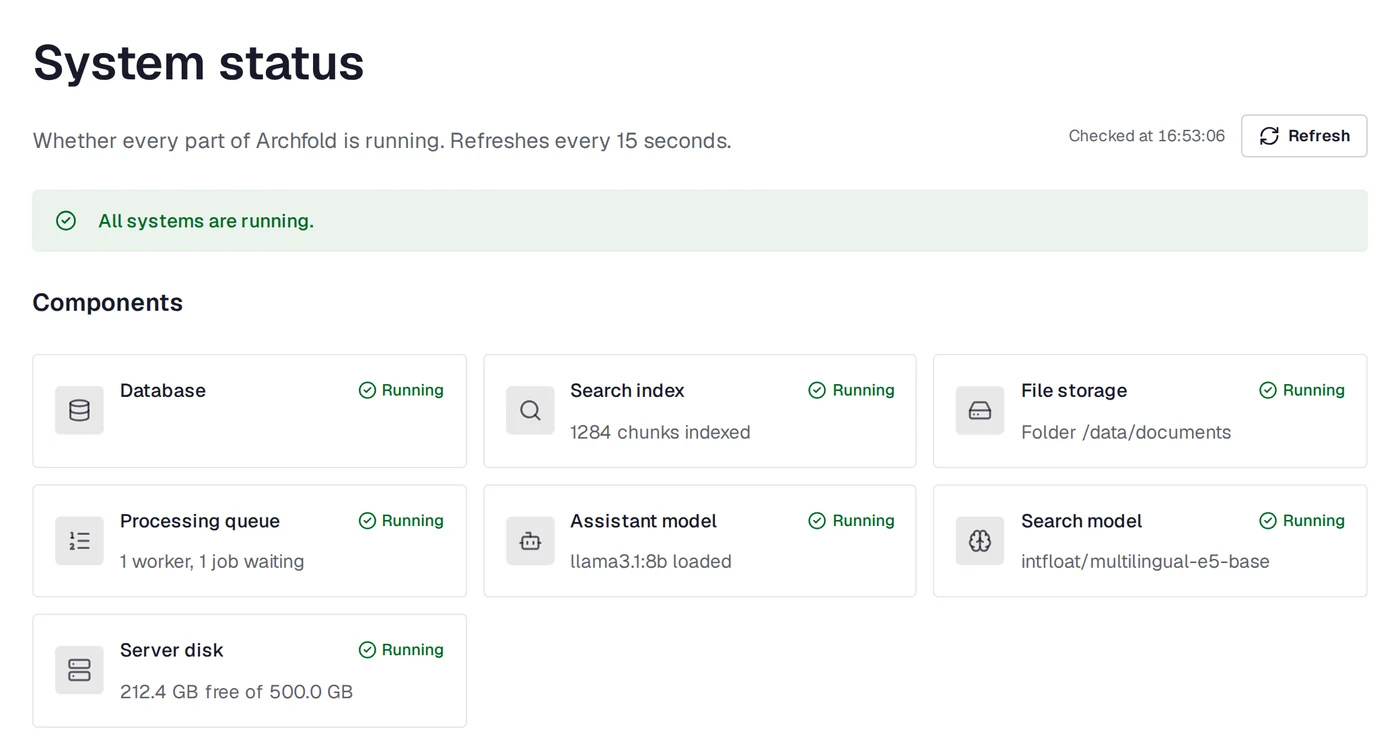
Chacun se connecte avec son compte professionnel
L'authentification unique fonctionne avec Microsoft Entra ID, ADFS, Keycloak, Okta et d'autres. Les rôles suivent les groupes de votre annuaire, et désactiver un utilisateur met fin à ses sessions immédiatement.
Les administrateurs conservent un mot de passe, pour pouvoir se connecter même quand le fournisseur est indisponible.
OIDC_ISSUER=https://login.example.comOIDC_CLIENT_ID=archfoldOIDC_GROUPS_CLAIM=groupsOIDC_ROLE_MAP=Archfold Admins=admin;Legal=legalDans la langue de votre équipe
L'interface et l'assistant fonctionnent en anglais, en espagnol et en français. Utilisez une seule langue, ou laissez chacun choisir la sienne dans l'en-tête. Chacun peut aussi basculer entre le mode clair et le mode sombre.
APP_LANGUAGE=enAPP_LANGUAGES=en,es,frChoisissez un modèle qui répond bien dans toutes les langues que vous activez.
Tout fonctionne sur un seul serveur, que vous contrôlez.
Archfold est une pile Docker Compose sur un seul serveur Linux. Il évolue verticalement : un serveur plus puissant, avec un plus gros GPU et un modèle plus grand, sert davantage de personnes.
Vos questions restent dans votre entreprise
Un assistant dans le cloud envoie vos questions, et les documents sur lesquels elles portent, vers les serveurs d'un tiers, selon les conditions et la politique de conservation de ce fournisseur. Selon le fournisseur et l'offre, elles peuvent aussi servir à entraîner des modèles.
Avec Archfold, aucun fournisseur n'intervient. Le modèle d'IA fonctionne sur votre serveur et, une fois installé, le système n'a aucune route vers Internet.
| Assistant dans le cloud | Archfold | |
|---|---|---|
| Le modèle d'IA | Sur les serveurs du fournisseur | Sur votre serveur |
| Son prix | Fixé par le fournisseur, et il peut changer | Aucun frais par utilisateur ni par question : votre coût, c'est le serveur |
| Vos questions et documents | Envoyés au fournisseur, selon ses conditions | Restent sur votre réseau |
| Entraînement sur vos données | Dépend du fournisseur et de l'offre | Aucun fournisseur ne reçoit vos données |
| Internet | Nécessaire pour chaque réponse | Nécessaire uniquement pour l'installation |
Le serveur n'a aucune sortie
Après l'installation, aucune partie d'Archfold ne peut accéder à Internet. Les gens accèdent à un seul service, le serveur web, en HTTPS.
Les seules exceptions sont celles que vous connectez vous-même : HashiCorp Vault, votre fournisseur SSO et votre stockage S3, chacun par un tunnel vers cette seule adresse. Les fichiers des documents arrivent sur S3 déjà chiffrés.
Votre serveur. Réseaux Docker internes, sans route vers Internet.
Chacun n'obtient de réponses que sur ce qu'il a le droit de lire
Chaque document a l'un des quatre niveaux d'accès : standard, restreint, confidentiel ou secret. L'assistant ne répond qu'à partir des documents que la personne qui pose la question a le droit de lire.
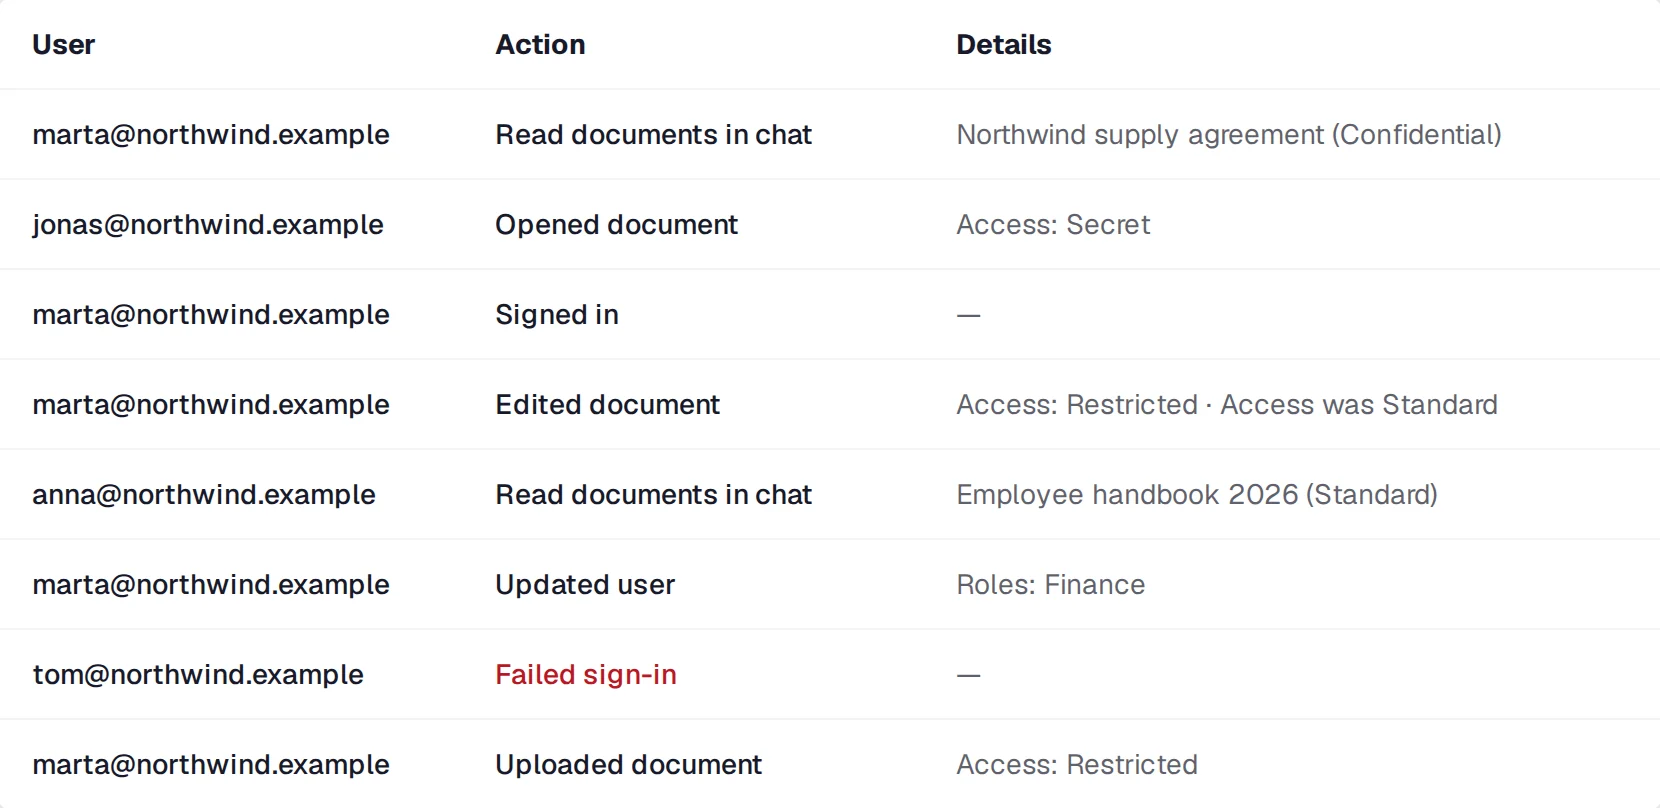
Le journal d'audit enregistre qui a lu quoi, y compris les documents que l'assistant a lus pour rédiger une réponse.
- Niveaux
- Appliqués dans la liste des documents, dans la recherche et dans chaque réponse
- Rôles
- Construits à partir de permissions, sans possibilité d'accorder plus que ce que l'on détient
- Journal d'audit
- Connexions, modifications, lectures de documents, lectures des chats d'autres utilisateurs
Vos données sont chiffrées avec votre clé
Les documents, les chats et les sauvegardes sont stockés chiffrés et illisibles sans votre clé. Conservez une copie de la clé en lieu sûr, hors du serveur.
Archfold ne chiffre pas certains éléments, et ils sont listés ici. Pour ceux-là, gardez les données du serveur sur un disque chiffré.
Chiffré
- Fichiers des documents
- Texte des documents
- Texte des fragments de recherche
- Chats
- Journal d'erreurs
- Sauvegardes
Non chiffré par Archfold
- Noms des documents
- E-mails des utilisateurs
- Journal d'audit
- Vecteurs de recherche
Gardez-les sur un disque chiffré, avec LUKS.
- Algorithme
- AES-256-GCM
- Clé
- Dans
backend/.envou HashiCorp Vault. Archfold refuse de démarrer avec une clé qui ne correspond pas aux données. - Rotation
deploy/deploy.sh rotate-keyrechiffre tout
Vos développeurs peuvent l'étendre sans fork
Vos propres fonctions se trouvent dans deux dossiers que les mises à jour ne touchent jamais : vous continuez donc à recevoir les mises à jour.
Cela couvre les endpoints d'API, les permissions, les tables et migrations de base de données, les tâches en arrière-plan, les pages, les liens de la barre latérale, les traductions et les thèmes.
from fastapi import APIRouter, Depends

from api.deps import require_permission

PERMISSIONS = (("crm.report", "CRM report", "View the CRM report"),)
router = APIRouter(prefix="/crm", tags=["crm"])


@router.get("/report")
async def report(_user=Depends(require_permission("crm.report"))) -> dict:
    return {"ok": True}
S'installe sur un serveur Linux, avec un seul script.
Toute personne à l'aise avec un serveur Linux et Docker peut le faire, sans Kubernetes ni équipe DevOps. Une configuration guidée choisit les modèles et génère tous les mots de passe et toutes les clés.
Ce qu'il vous faut
- Serveur
- Linux 64 bits, un processeur x86-64 avec AVX2, un SSD. Voir les tailles sous Matériel.
- Logiciels
- Docker avec Docker Compose v2,
gitetuv. Les GPU NVIDIA nécessitent NVIDIA Container Toolkit. - Nom d'hôte
- Par exemple
archfold.company.local - Internet
- Uniquement pendant l'installation, pour télécharger les modèles d'IA
Récupérez le code et lancez la configuration guidée
$ git clone https://github.com/deformator852/archfold && cd archfold$ cd backend && uv run install && cd ..# Keep the encryption key it shows in a safe place outside the serverDéfinissez l'adresse et le certificat
SITE_ADDRESS=archfold.company.localTLS=internalCompilez et démarrez
$ deploy/deploy.sh build$ deploy/deploy.sh upCréez le premier administrateur
$ deploy/deploy.sh admin you@company.com# then open https://archfold.company.local
Le maintenir en service
Les mises à jour, les sauvegardes et les restaurations utilisent le même script. Les migrations de base de données s'exécutent au démarrage, et vos extensions restent telles quelles.
Lisez le guide de déploiementLancez-le pour le développement
# Update$ git pull$ deploy/deploy.sh build && deploy/deploy.sh up # Encrypted backup, and restore after checking every part of it$ deploy/deploy.sh backup /path/to/backups$ deploy/deploy.sh restore /path/to/backups # Change settings$ cd backend && uv run configureDémarre sur un serveur de 16 Go sans GPU.
Un modèle 8B répond sur un serveur ordinaire. Ajoutez plus tard un GPU pour des réponses plusieurs fois plus rapides, ou un plus gros pour davantage de personnes. Sans GPU, une réponse prend plusieurs dizaines de secondes.
Petite
Jusqu'à 50 utilisateurs
- Modèle d'IA
- llama3.1:8b (par défaut) ou qwen3:8b
- Minimum
- 4 cœurs CPU, 16 Go de RAM, SSD de 80 Go, sans GPU
- Recommandé
- 8 cœurs CPU, 32 Go de RAM, SSD de 200 Go, GPU avec 12 Go de VRAM
- Réponses simultanées
- 1 à 2 sur CPU, 4 avec un GPU
Moyenne
De 50 à 500 utilisateurs
- Modèle d'IA
- gemma3:12b
- Minimum
- 8 cœurs CPU, 32 Go de RAM, SSD de 150 Go, GPU avec 16 Go de VRAM
- Recommandé
- 16 cœurs CPU, 64 Go de RAM, SSD NVMe de 500 Go, GPU avec 24 Go de VRAM
- Réponses simultanées
- 2 au minimum, 4 recommandées
Grande
500 utilisateurs et plus
- Modèle d'IA
- gemma3:27b ou qwen3:32b, llama3.3:70b pour les meilleures réponses
- Minimum
- 16 cœurs CPU, 64 Go de RAM, SSD NVMe de 500 Go, GPU avec 48 Go de VRAM
- Recommandé
- 32 cœurs CPU, 128 Go de RAM, SSD NVMe de 1 To, 80 Go de VRAM ou plus
- Réponses simultanées
- 4 ou plus
Ces chiffres sont des estimations pour le contexte par défaut de 16 384 tokens. Prévoyez de l'espace disque pour les images Docker (environ 20 Go), les modèles d'IA (5 Go pour un modèle 8B, environ 43 Go pour un modèle 70B) et environ deux fois la taille de vos documents. Gardez les sauvegardes sur une autre machine.
Développé au grand jour
Les signalements de bugs et les pull requests sont les bienvenus. Ouvrez une issue avant un changement important, pour ne pas construire quelque chose qui ne pourra pas être fusionné.
Créé et maintenu par Nikita Kostenko, développeur indépendant : LinkedIn, GitHub, nikitakostenko.com.
- README
- Fonctions, réglages et toutes les commandes
- Guide de déploiement
- Installation, SSO, S3, sauvegardes, chiffrement du disque, Vault, dépannage
- Guide de personnalisation
- Extensions dans
custom/: endpoints, pages, thèmes, migrations - Journal des modifications
- Ce que change chaque version
- Contribuer
- Les vérifications à lancer et ce qu'un changement doit inclure
- Politique de sécurité
- Comment signaler une vulnérabilité